01
具身基礎模型(VLA / WAM)
研究視覺-語言-動作模型與世界動作模型,讓機器人從視覺、語言與自身狀態直接生成動作,並在長程任務中進行推理與規劃。

FIR Lab 聚焦具身智能,研究讓機器人理解物理世界、在真實環境中可靠完成複雜操作的具身基礎模型與學習方法。
研究視覺-語言-動作模型與世界動作模型,讓機器人從視覺、語言與自身狀態直接生成動作,並在長程任務中進行推理與規劃。
學習環境如何隨機器人動作而變化,用於預測動作後果、評估策略與生成訓練數據。
從示範、遙操作與第一視角影片中學習操作技能,研究共享自主、失敗恢復與接觸豐富操作,並在真機上部署驗證。
構建真實與合成數據閉環、仿真評估環境,以及支撐實驗的機器人硬件,讓研究成果落到真實任務。
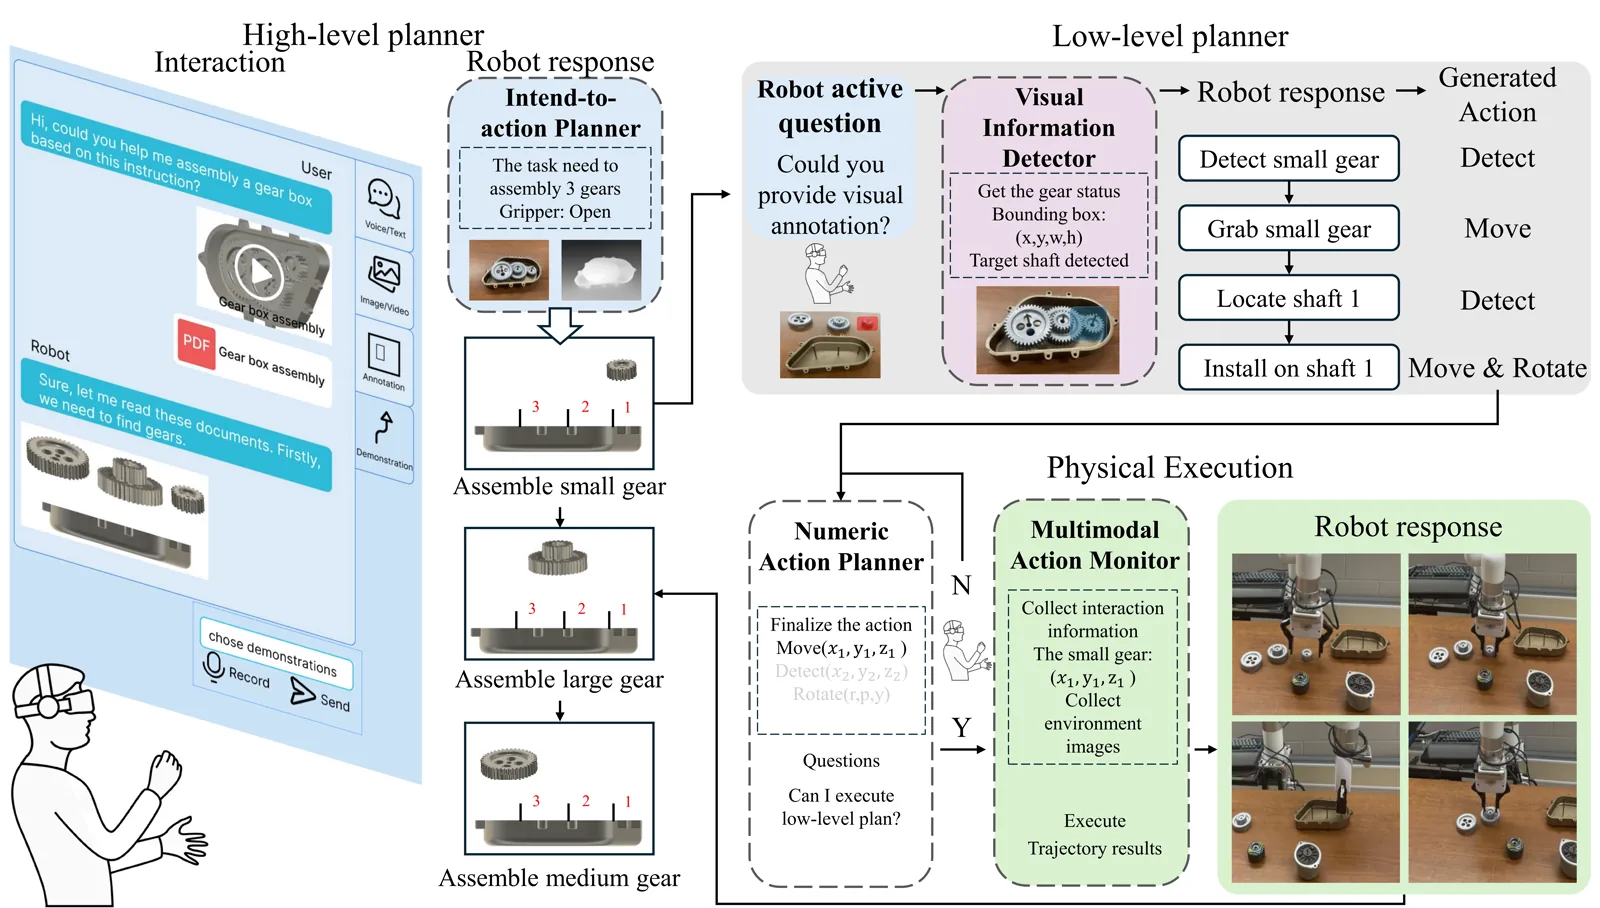
讓人與視覺-語言-動作模型協作,完成長程裝配任務。
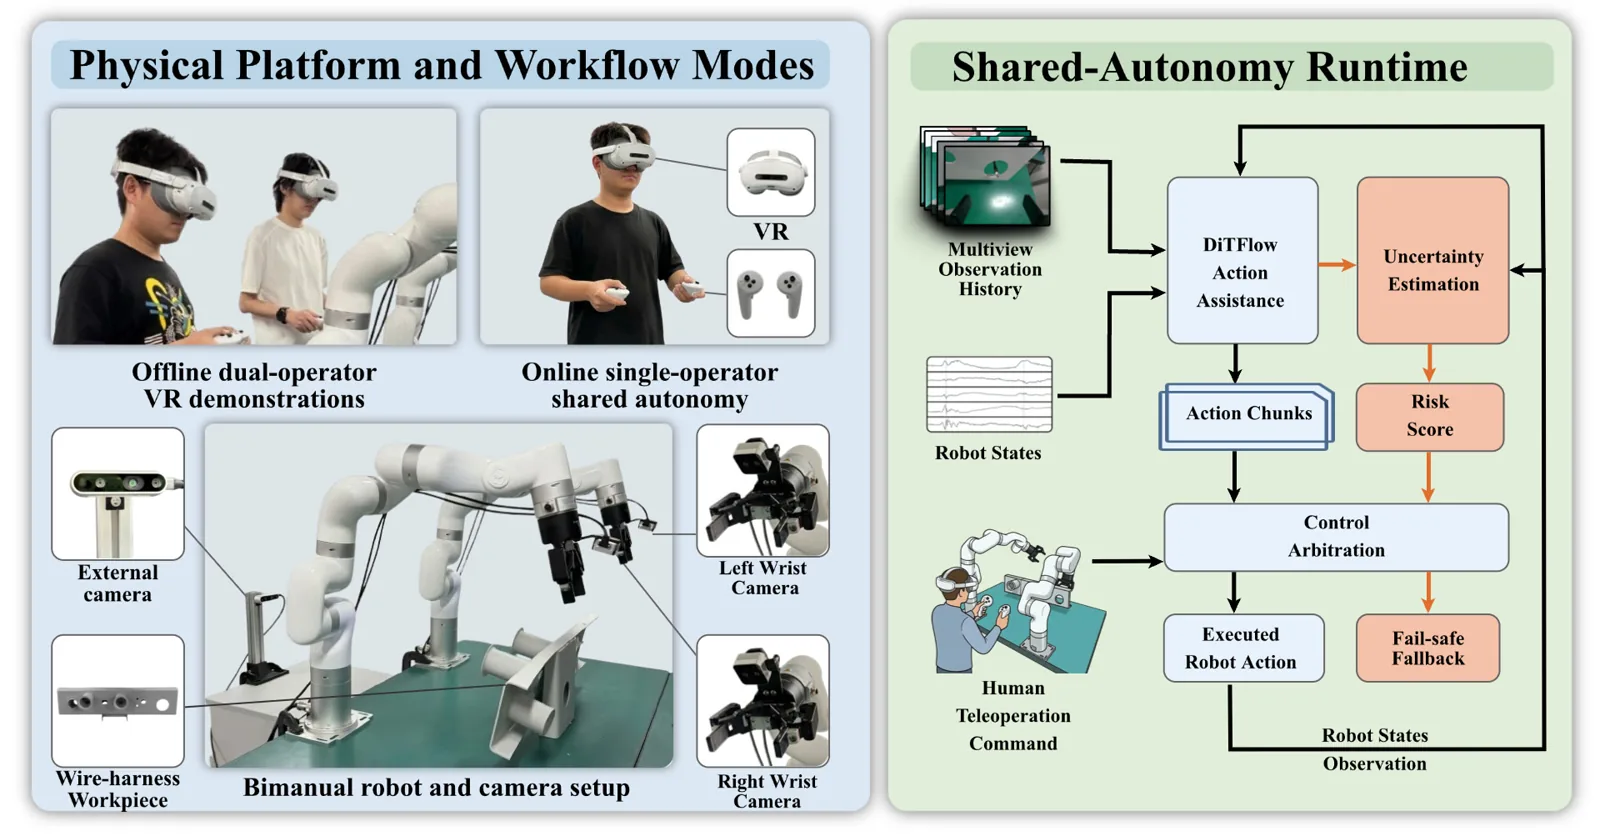
模型預設執行,風險升高時把控制權交還操作者。
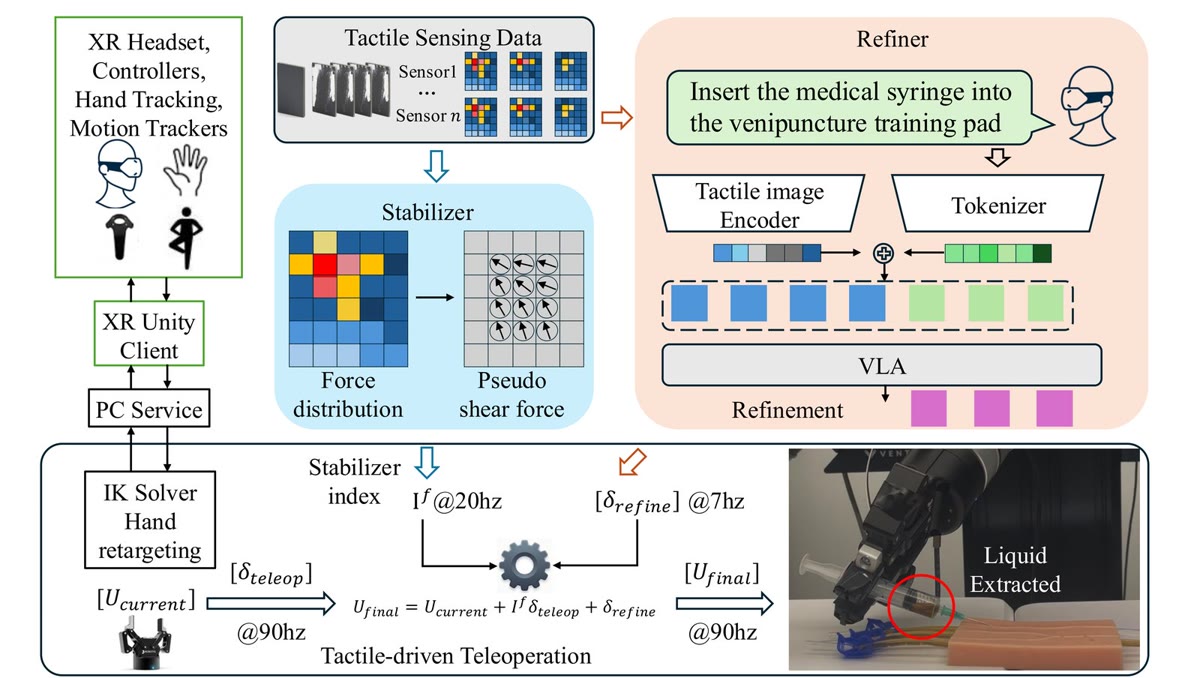
結合觸覺感知與 VLA 動作精修,完成接觸豐富的精細操作。
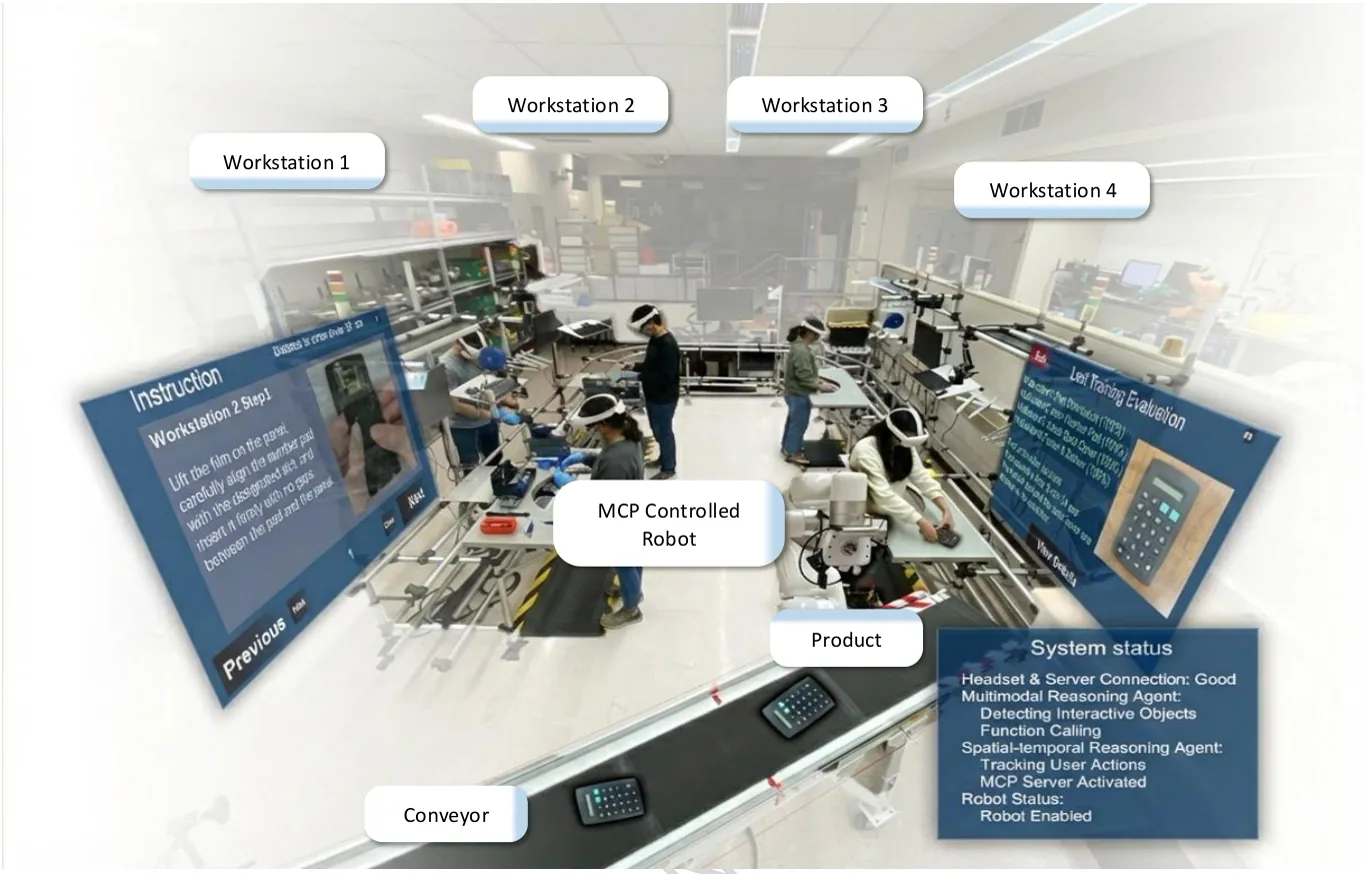
多模態與時空推理智能體協調機器人完成裝配流程。
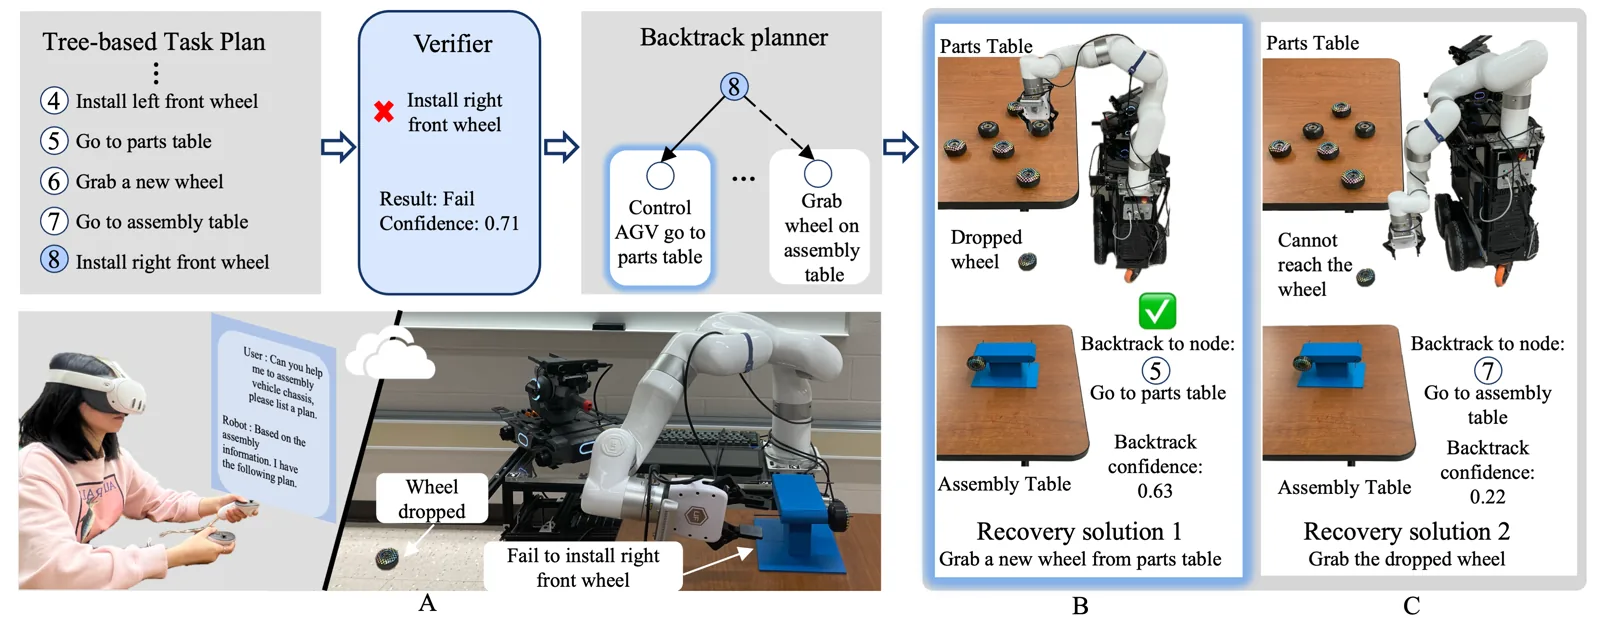
在長程任務中檢測執行失敗,並生成恢復策略。
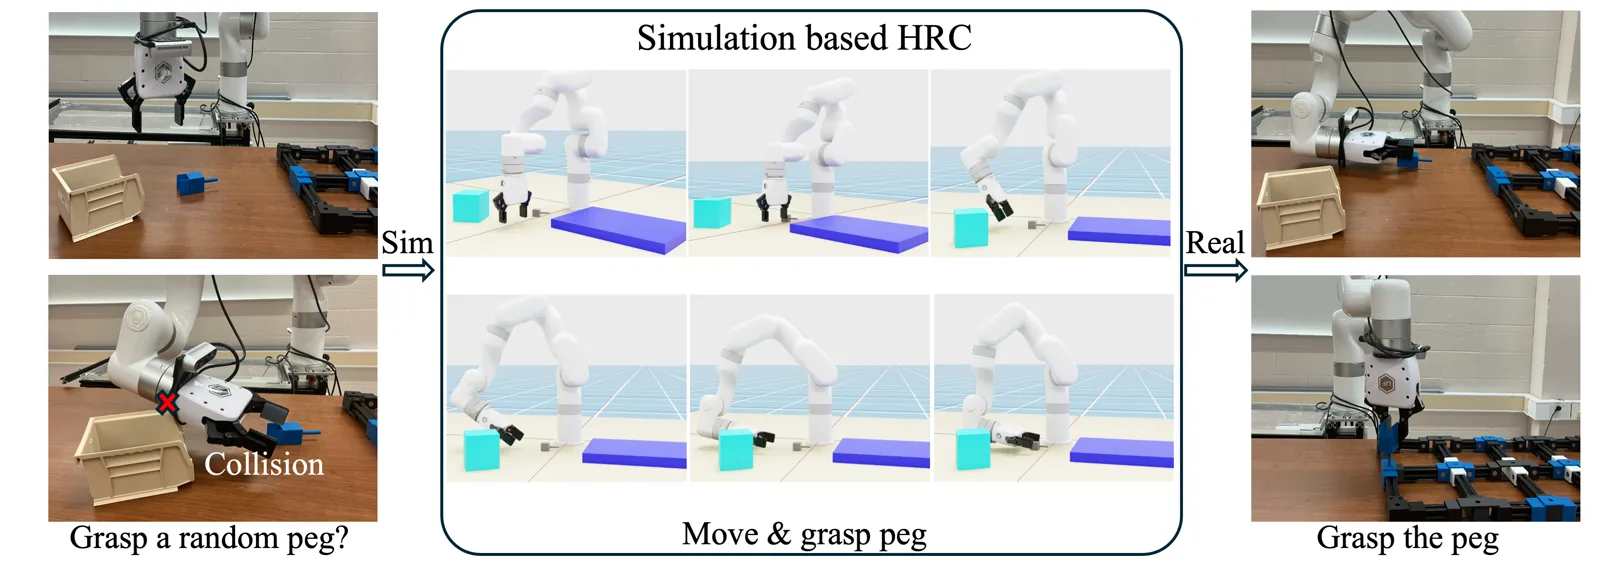
在真機部署前,用物理仿真評估機器人操作策略。
FIR Lab 依託中國科學院香港創新研究院基礎與前沿科學研究中心,配備: