01
具身基础模型(VLA / WAM)
研究视觉-语言-动作模型与世界动作模型,让机器人从视觉、语言与自身状态直接生成动作,并在长程任务中进行推理与规划。

FIR Lab 聚焦具身智能,研究让机器人理解物理世界、在真实环境中可靠完成复杂操作的具身基础模型与学习方法。
研究视觉-语言-动作模型与世界动作模型,让机器人从视觉、语言与自身状态直接生成动作,并在长程任务中进行推理与规划。
学习环境如何随机器人动作而变化,用于预测动作后果、评估策略与生成训练数据。
从示范、遥操作与第一视角视频中学习操作技能,研究共享自主、失败恢复与接触丰富操作,并在真机上部署验证。
构建真实与合成数据闭环、仿真评估环境,以及支撑实验的机器人硬件,让研究成果落到真实任务。
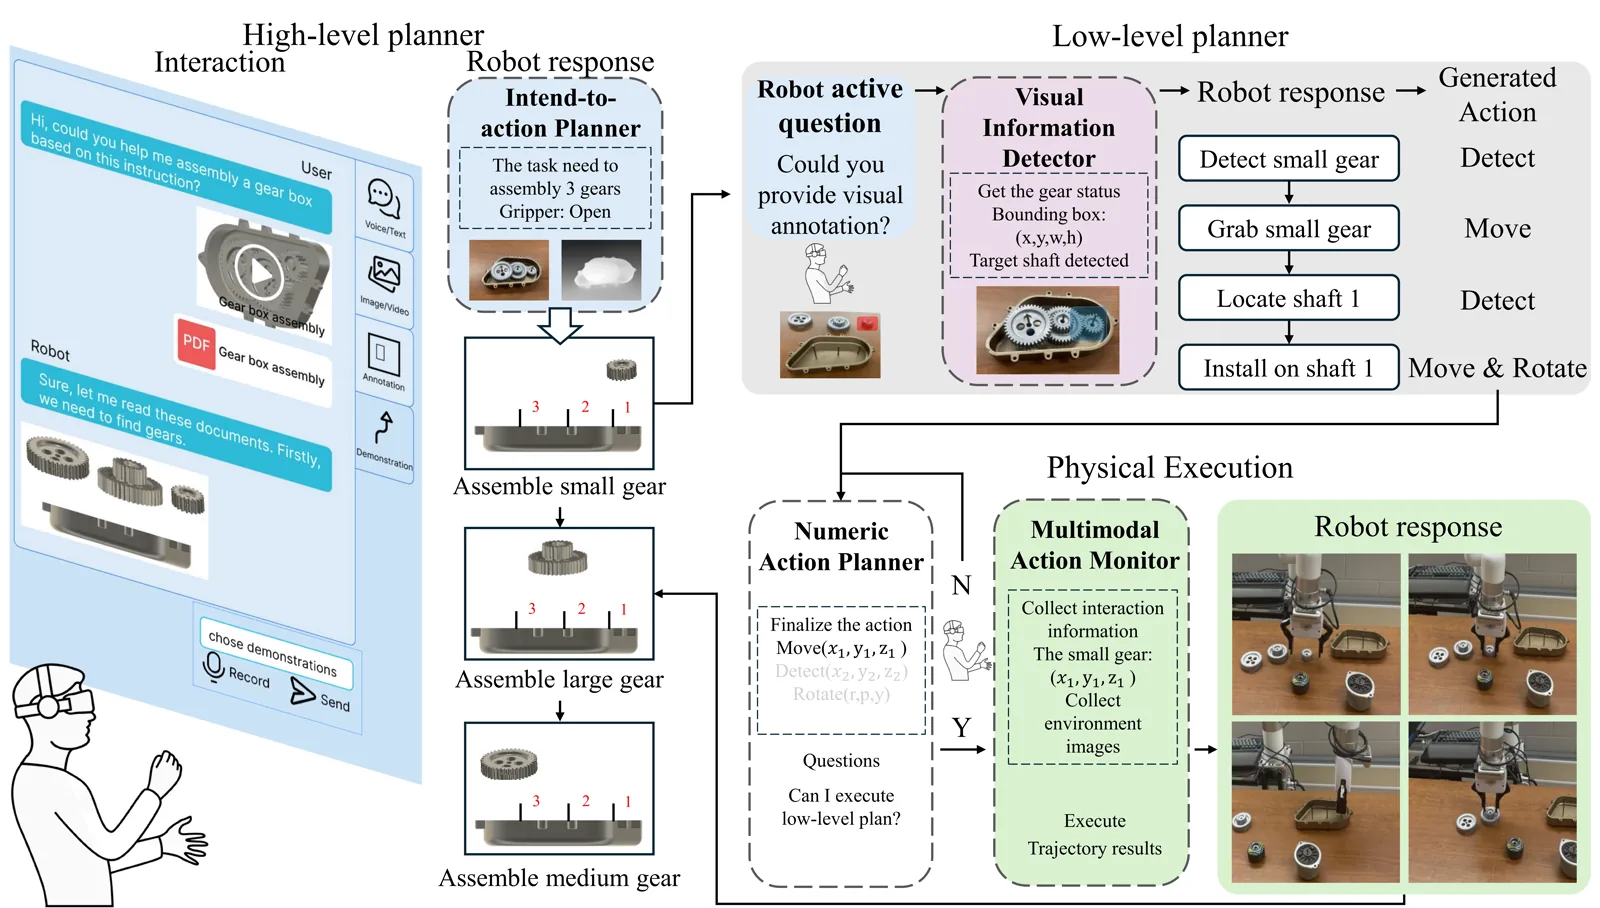
让人与视觉-语言-动作模型协作,完成长程装配任务。
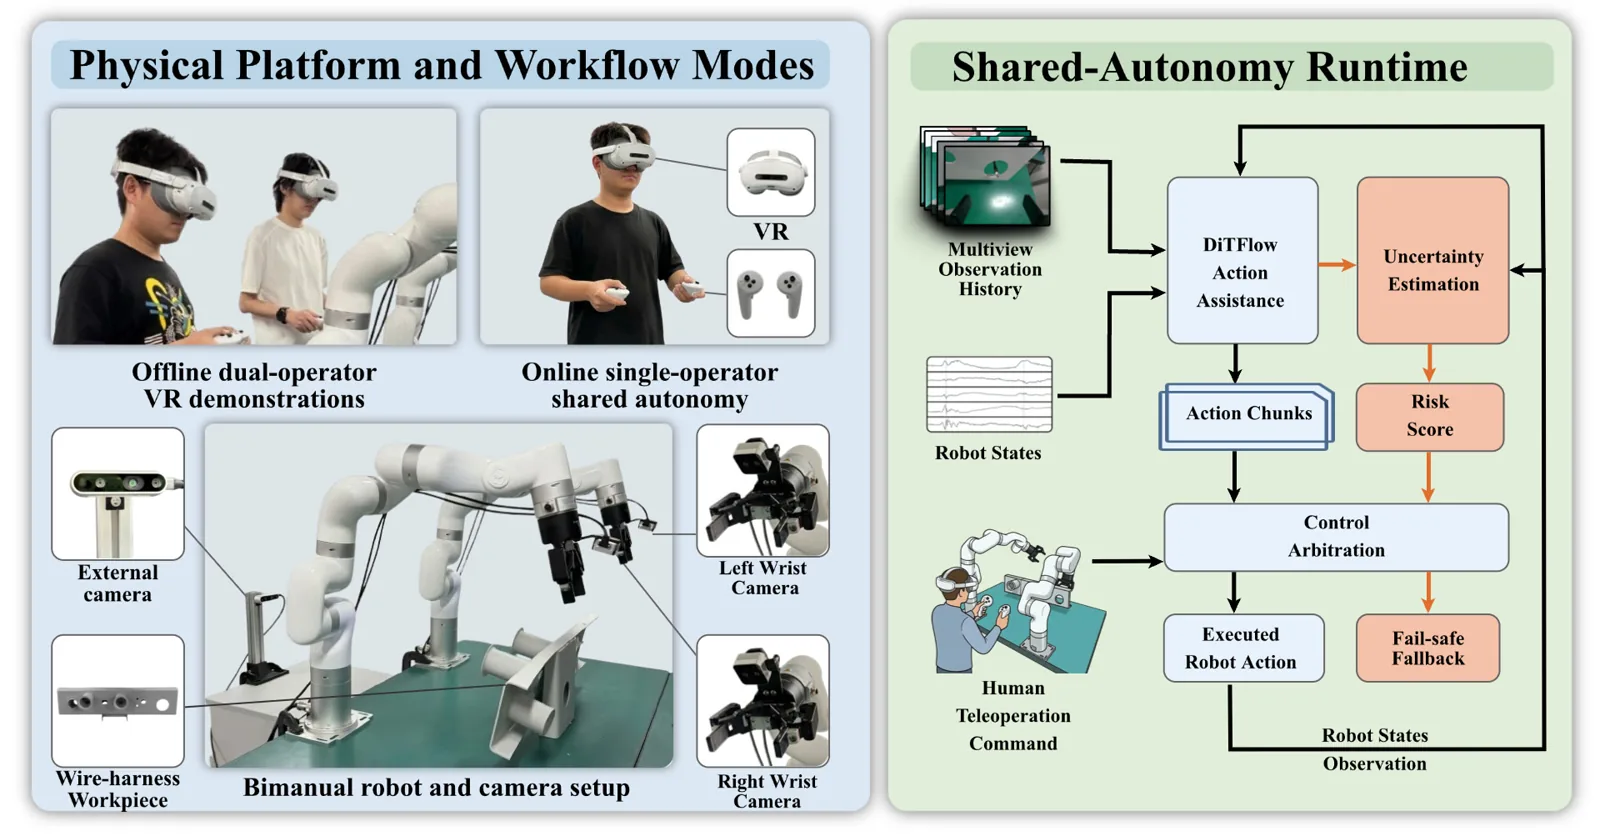
模型默认执行,风险升高时把控制权交还操作者。
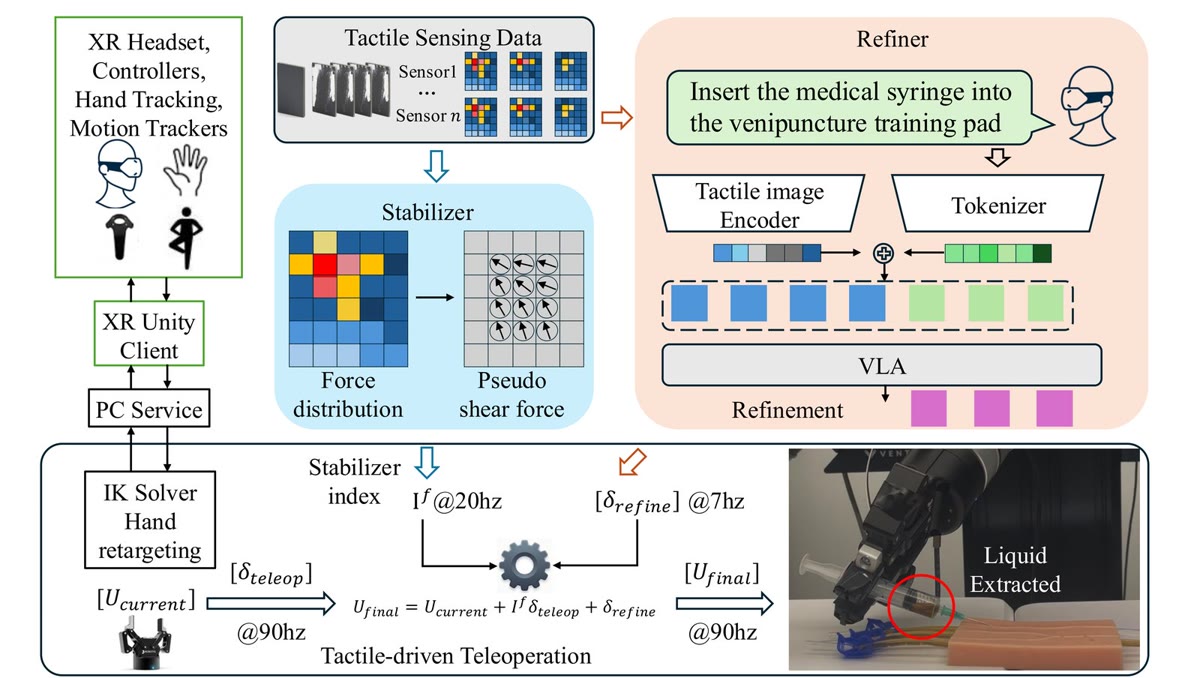
结合触觉感知与 VLA 动作精修,完成接触丰富的精细操作。
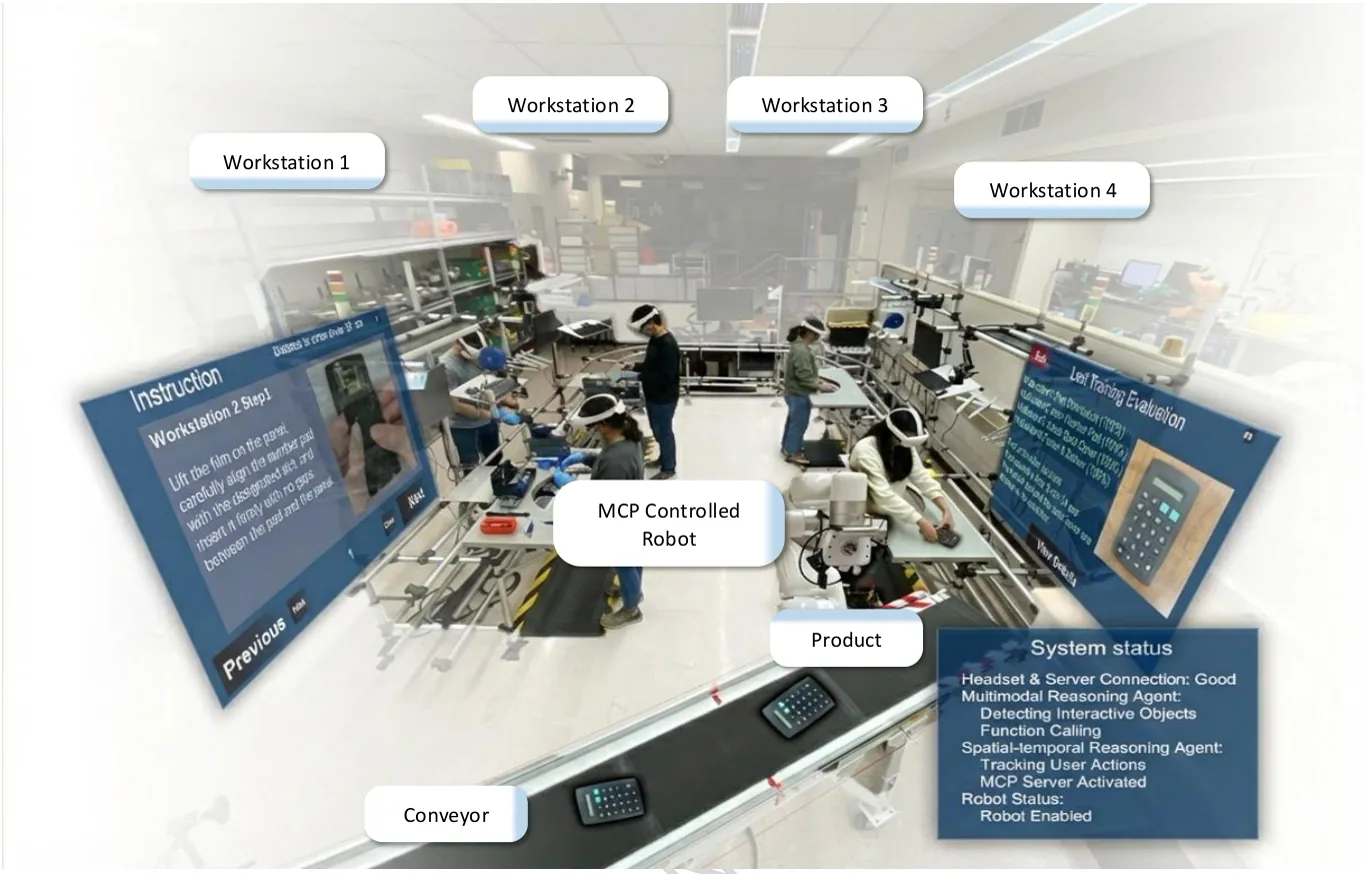
多模态与时空推理智能体协调机器人完成装配流程。
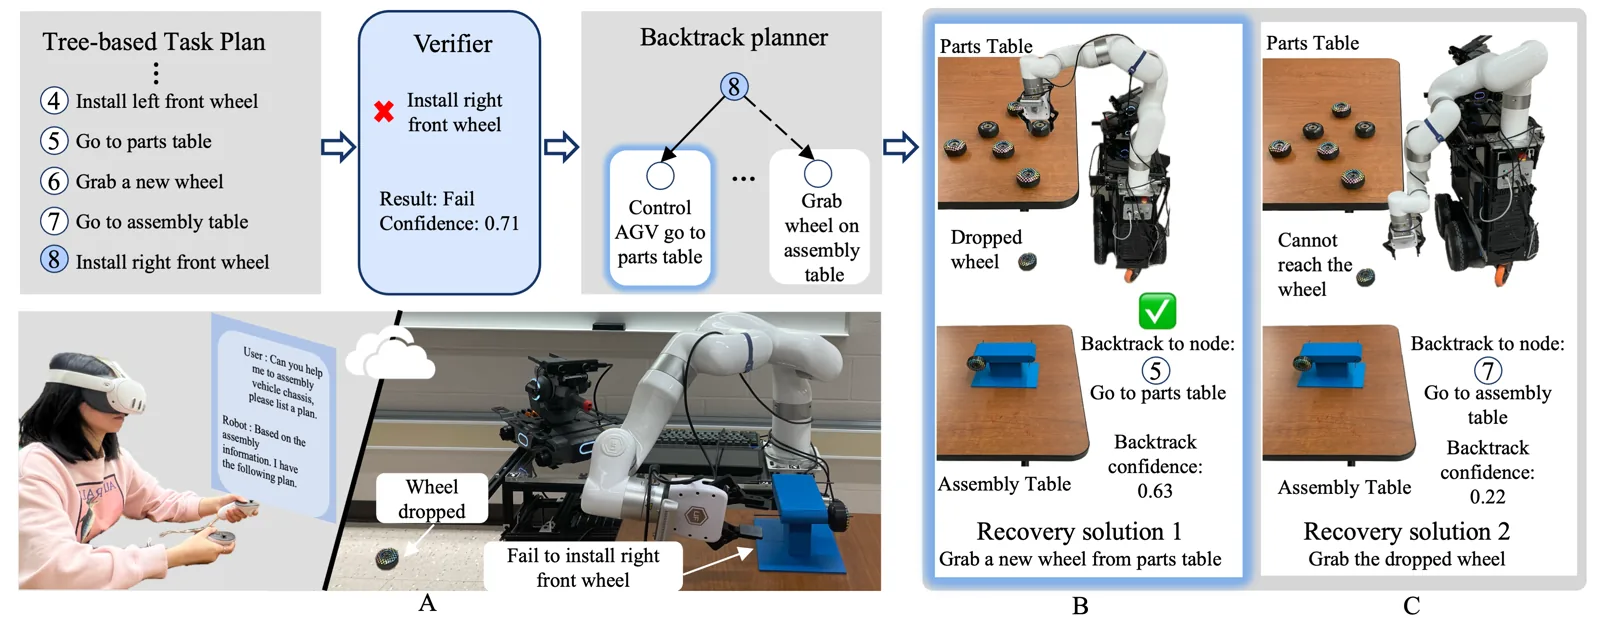
在长程任务中检测执行失败,并生成恢复策略。
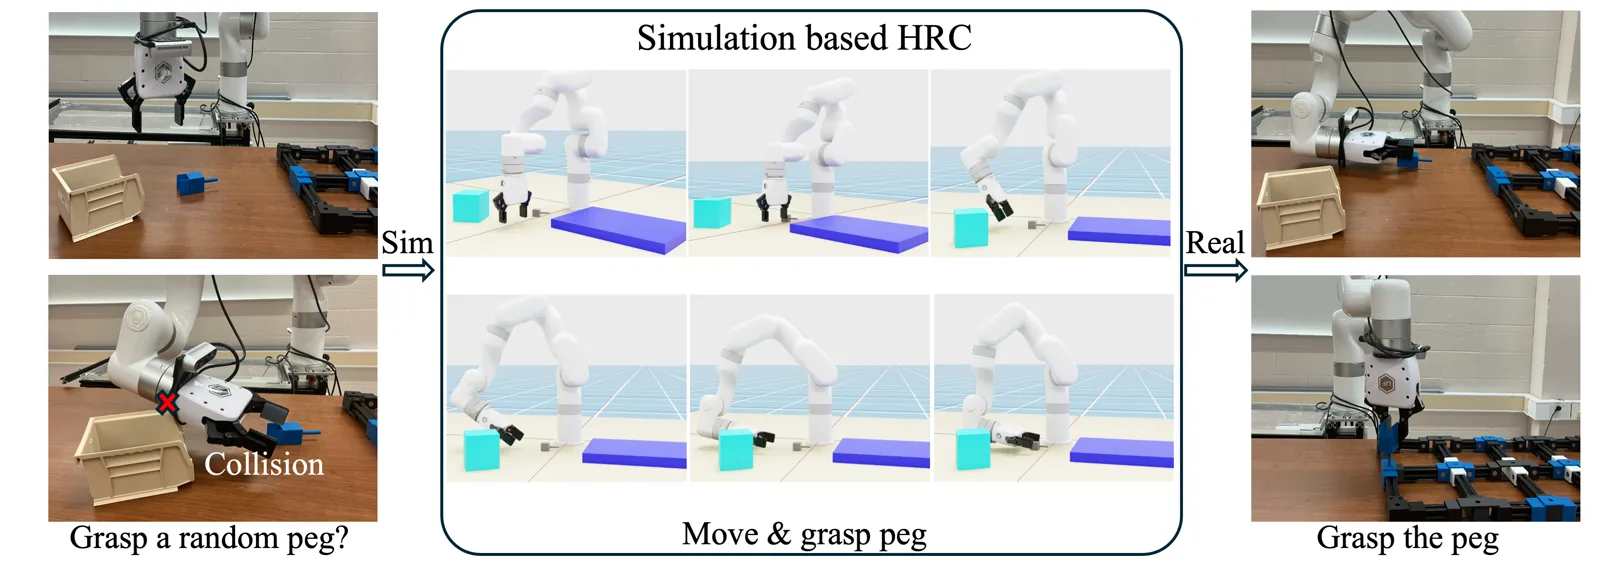
在真机部署前,用物理仿真评估机器人操作策略。
FIR Lab 依托中国科学院香港创新研究院基础与前沿科学研究中心,配备: